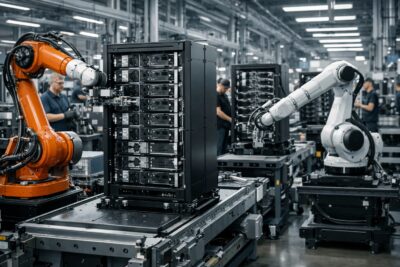

Il modo classico di programmare un robot industriale parte da una certezza: sappiamo in anticipo che cosa dovrà fare. Skild AI sta provando a rompere questa rigidità.
Il 10 settembre NVIDIA ha descritto S1, un modello robotico di Skild AI progettato per imparare compiti mai visti e di lunga durata da una singola dimostrazione video. Il modello usa il video come contesto e tenta di eseguire il compito senza aggiornare i propri pesi.
Dal codice alla dimostrazione
Gli esseri umani imparano continuamente osservando. Vediamo qualcuno montare un oggetto e proviamo a replicare l’azione. Per un robot è molto più difficile: un video non contiene direttamente forze, profondità, attrito e resistenza.
Per questo abbiamo raccontato i world model come una delle vie verso intelligenze realmente operative. Il robot deve prevedere come il mondo reagirà alle sue azioni.
Perché una sola dimostrazione è una soglia economica
Se servono migliaia di esempi per ogni nuovo compito, la robotica resta costosa. Una dimostrazione singola cambia l’economia. Una piccola fabbrica potrebbe mostrare un nuovo assemblaggio al robot senza settimane di engineering.
È il seguito naturale della physical AI industriale: non costruire soltanto impianti perfetti da zero, ma entrare in ambienti esistenti e adattarsi.
Capire l’intenzione, non copiare i pixel
Se una scatola è spostata di venti centimetri, copiare la traiettoria del video fallisce. Il sistema deve capire ciò che rimane invariato: prendere la scatola, orientarla, inserirla.
È la differenza tra imitazione e rappresentazione dell’obiettivo. L’abbiamo già vista nell’articolo sui robot che imparano a prevedere.
La fabbrica si sposta anche nel data center
Skild usa tecnologie NVIDIA per dati sintetici, training, simulazione e deployment. La physical AI nasce dalla convergenza fra GPU, simulatori, gemelli digitali e robot reali.
Il data center diventa quindi parte della fabbrica. Questo lega la robotica alla nuova infrastruttura AI.
Il limite: un video non contiene la fisica
Le affermazioni arrivano dalle aziende coinvolte e dovranno essere validate in contesti diversi. Una singola dimostrazione non contiene tutte le proprietà fisiche dell’oggetto.

Per questo la robotica generale sarà probabilmente multimodale: video, profondità, forza, tatto, audio e propriocezione.
Entro 2–3 anni
Fra il 2028 e il 2029 potremmo vedere robot industriali riconfigurabili in ore anziché settimane. Il collo di bottiglia sarà la sicurezza: un modello che generalizza bene quasi sempre può essere inutilizzabile se gli errori residui danneggiano persone o macchinari.
Fra dieci anni
Verso il 2036 il valore potrebbe spostarsi dall’hardware specializzato alla capacità di apprendere localmente. Una stessa piattaforma potrebbe lavorare in magazzino, laboratorio o fabbrica con policy differenti.
Quando insegnare a una macchina comincia ad assomigliare al mostrare invece che al programmare, la robotica smette di essere soltanto automazione. Diventa apprendimento incarnato.